Kleine Modelle, große Wirkung: Was 16 GB Grafikspeicher 2026 leisten
Die große Frage hieß noch vor einem Jahr: Wie viel Grafikspeicher braucht ein nützliches KI-Modell, damit es auf eigener Hardware läuft? Die Antwort des Jahres 2026 fällt deutlich kürzer aus: 16 GB. Die Modelle sind nicht kleiner geworden, wohl aber ihr Gewicht. Quantisierung, Flash-Attention und kompakte Architekturen bringen Modelle so nah an die Hardware, dass eine einzige Grafikkarte im Serverraum das trägt, wofür man vor einem Jahr noch einen ganzen Rack voller Karten brauchte. Was das für Ihren Betrieb heißt: Der lokale Server ist betriebsreif.
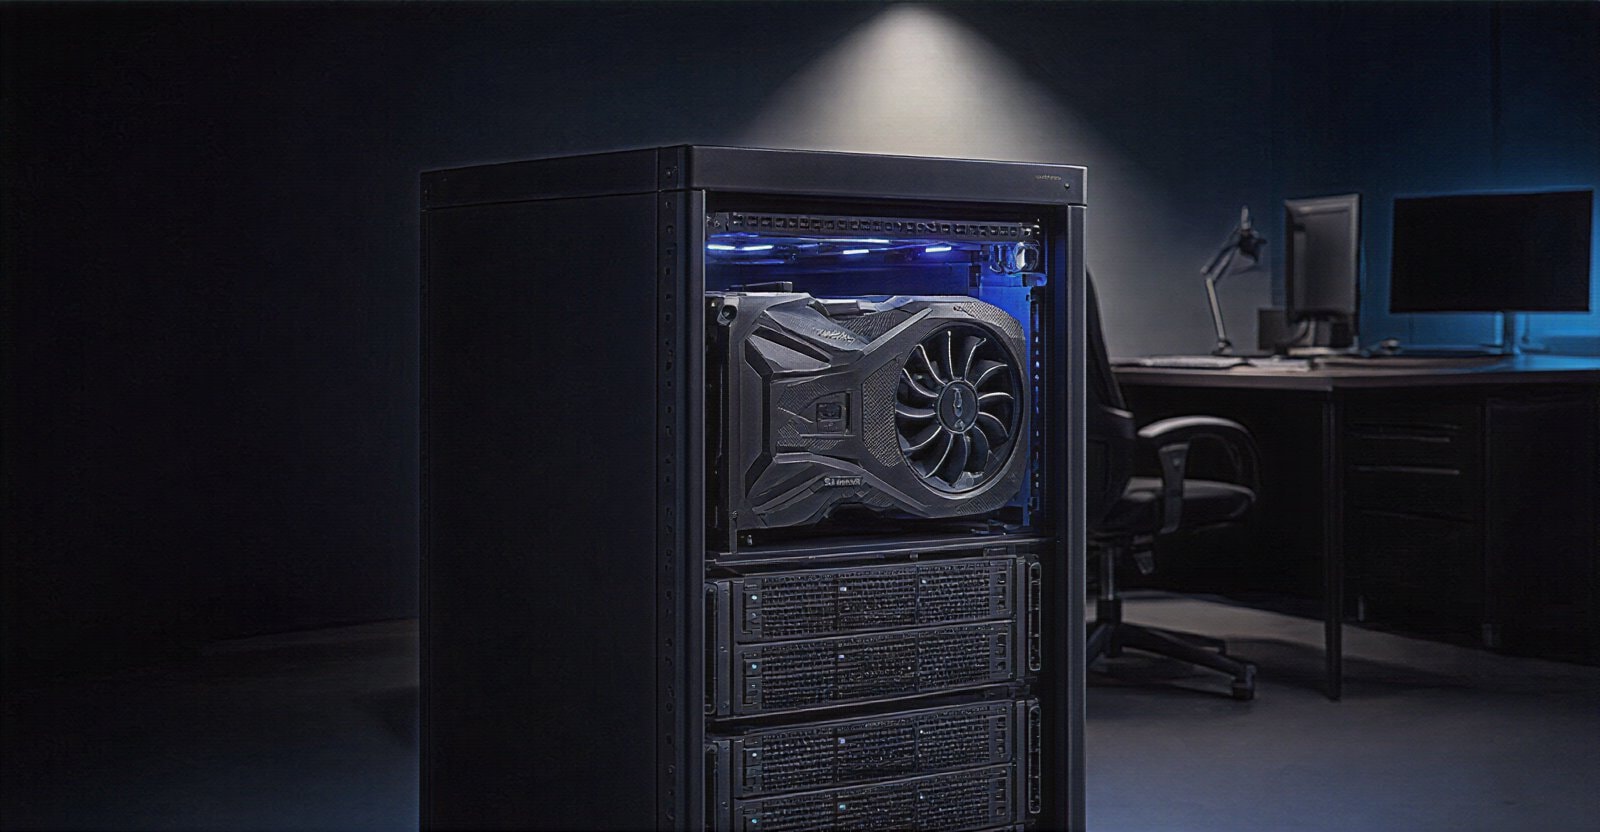
Bild mit KI erstellt
KI-News · 27. September 2026 · 3 min Lesezeit · Von Thomas Dick
Text und Bilder in diesem Beitrag wurden mit KI erstellt.
Warum kleine Modelle so stark geworden sind
Der Trick ist simpler, als man denkt. Statt immer größere Modelle zu bauen, wird klüger damit umgegangen, was gespeichert, berechnet und im Speicher gehalten wird. Drei Techniken leisten den größten Teil der Arbeit. Quantisierung komprimiert die Gewichte des Modells, Aufmerksamkeitsbeschleunigung verdoppelt die Rechengeschwindigkeit des Modellkerns, und Cache-Kompression halbiert den Speicher, den lange Texte binden. Ein Modell, das in voller Präzision 55 GB belegt, belegt mit drei Bit pro Gewicht nur noch rund 10 GB und passt auf eine 16-GB-Karte. Der Präzisionsverlust ist im Ergebnis selten zu sehen.
- Quantisierung: Statt jedes Gewicht mit 16 oder 32 Bit zu speichern, speichert man es mit 8 oder 4 Bit (int8, w4a8). Das Modell wird zwei bis viermal kleiner, der Präzisionsverlust bleibt klein.
- Flash-Attention: Die Kernberechnung des Modells läuft doppelt so schnell und mit weniger Speicher, ohne dass sich das Ergebnis verändert.
- KV-Cache-Kompression: Der Arbeitspeicher für lange Texte wird komprimiert (q8_0). Lange Gespräche und lange Dokumente passen in die Hälfte des Speichers.
Was in unserem Serverraum wirklich läuft
Wir messen, statt zu schätzen. Unser Textmodell mit 27 Milliarden Parametern liefert im Normalbetrieb 87,7 Token pro Sekunde, schneller als das Auge liest. Das Sehenmodell mit 4 Milliarden Parametern belegt 3,3 GB und liest Fotos von Rechnungen, Screenshots und Dokumentscans in rund sechs Sekunden. Das Bildmodell Qwen-Image 2.1 erzeugt auf derselben Karte in etwa 60 Sekunden ein Bild in 1600 auf 832 Pixeln, und das Sehenmodell kann das Ergebnis prüfen, ohne dass ein Bild das Haus verlässt. Entscheidend ist nicht die Hardware-Liste, sondern die Kombination: Text, Bild und Sehen auf einer einzigen 16-GB-Karte.
Was das für Ihren Betrieb bedeutet
Die Kosten rechnen sich in dem Moment, in dem man sie mit der Cloud vergleicht. Eine Grafikkarte kostet ein paar hundert Euro, einmal. Was dafür im Haus bleibt: Ihre Daten verlassen das Haus nicht. Keine Hochladung von Rechnungen und Kundendateien, kein Tracking, kein Abo pro Kopf, keine AGB, die entscheiden, wem die Ergebnisse gehören. Und das Modell läuft, wenn Sie es brauchen, auch dann, wenn das Internet ausfällt. Das ist der Unterschied zwischen einem Cloud-Dienst und einem Geschäftsprozess, auf den Sie sich verlassen können.
Ehrlich: Wo die lokale KI noch schwach ist
Die stärksten Cloud-Modelle gewinnen nach wie vor bei reinem Erfinden: lange kreative Texte, komplexe Strategien, Forschung an der Spitze. Was nicht mehr gilt, ist, dass das lokale Modell für nützliche Geschäftsaufgaben zu klein ist. Die praktikable Lösung heißt hybrid: Dokumente, Bilder, internes Wissen und Alltagsprozesse laufen im Haus, kreative Spitzen laufen in der Cloud. Bezahlt wird nur der Teil, der die Cloud wirklich braucht, und alles andere bleibt, wo es hingehört: im Haus.
Kurz gesagt: 2026 ist das Jahr, in dem die lokale KI vom Hobbyprojekt zur Betriebs-Infrastruktur geworden ist. Wenn Sie wissen wollen, was Ihre Daten im eigenen Serverraum leisten können, sprechen Sie uns an. Wir zeigen Ihnen eine laufende Konfiguration, mit Messwerten und ohne Demo-Magie. Und wer mehr über das erwähnte Bildmodell wissen will: Im Blogbeitrag Qwen-Image 2.1: Bild-KI, die auf einer Grafikkarte läuft erklären wir es im Detail.Qwen-Image 2.1: Bild-KI, die auf einer Grafikkarte läuft
Weitere Beiträge
Lokale KI · 23. September 2026
Lokale KI: Warum es auf diesen Unterschied ankommt
Weiterlesen
Internet-Notfall · 16. September 2026
Internet ausgefallen: So läuft der Betrieb weiter
Weiterlesen
KI-News · 09. September 2026
Qwen-Image 2.1: Bild-KI, die auf einer Grafikkarte läuft
Weiterlesen
Lokale KI · 29. August 2026
KI in der Buchhaltung: So erledigen Sie Belege automatisch
Weiterlesen
KI-Agent · 22. August 2026
KI-Chatbot für den Onlineshop: Antworten ohne Wartezeit
Weiterlesen
Datenschutz · 15. August 2026
Lokale KI statt Cloud: Was das für den Datenschutz heißt
Weiterlesen
KI-Agent · 8. August 2026
KI für Handwerker: Das Angebot aus den Fotos vom Einsatz
Weiterlesen
KI-News · 1. August 2026
Ist Ihre Website für die KI-Suche vorbereitet?
WeiterlesenAnliegen schildern, Rückmeldung bekommen
Kurz schildern, worum es geht, wir melden uns.